取り扱いGPUラインナップ
line Up
GPUラインナップ
NVIDIA
GPUのご紹介です。ご用途に合わせてお選びいただくことが可能です。
「どれがいいかわからない」などご相談も受けつけておりますので是非お問合せください。
NVIDIA GB200
NVL72について
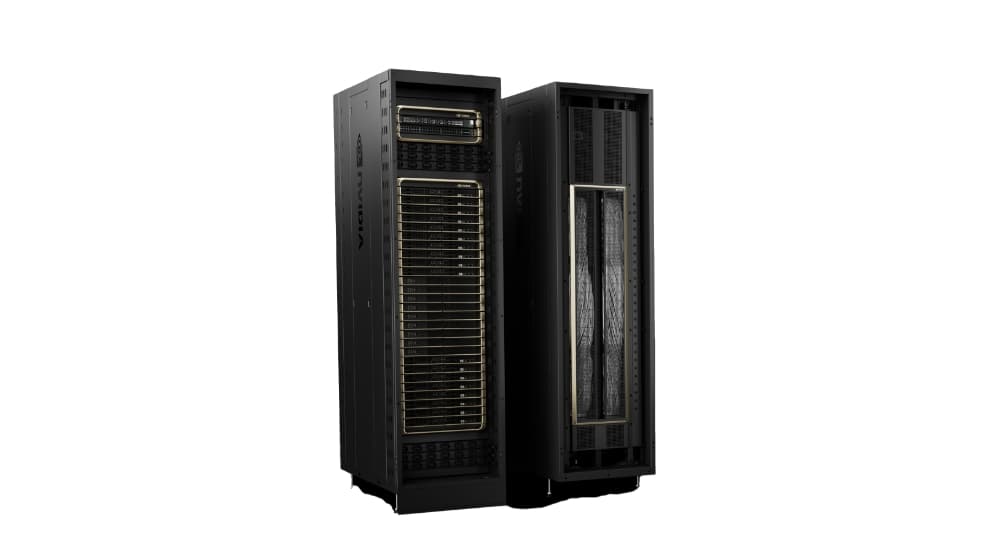
GB200 NVL72 は、36個の Grace CPU と 72個の Blackwell GPU を1つラックスケールデザインで接続します。GB200 NVL72 は、液冷式ラックスケールソリューションで、72-GPU NVLink ドメインが1つの巨大 GPU として機能し、兆単位パラメーター LLM推論のリアルタイム性を30倍高速化します。
NVIDIA GB200 NVL72 の特長
-
リアルタイム
LLM推論GB200 NVL72 は、最先端の機能と、FP4 AIを可能にする第2世代 Transformer Engine を導入し、第5世代 NVIDIA NVLink と組み合わせることで、兆単位のパラメーター言語モデルに対して30倍高速なリアルタイム LLM推論性能を提供します。
-
大規模な
トレーニングGB200 には、FP8 精度を備えた、より高速な第2世代の Transformer Engine が搭載されており、大規模言語モデルの学習を4倍高速化することができます。この画期的な技術を補完するのが第5世代 NVLink です。これは毎秒1.8テラバイトのGPU間相互接続、InfiniBand ネットワーク、NVIDIA Magnum IO™ ソフトウェアを提供します。
-
電力効率に
優れたインフラ液冷 GB200 NVL72ラックは、データセンターの二酸化炭素排出量とエネルギー消費を削減します。液冷は計算処理密度を高め、使用されるフロア面積を減らし、大規模なNVLink ドメインアーキテクチャでGPU通信を高帯域、低遅延にします。NVIDIA H100空冷インフラと比較すると、GB200は同じ電力でパフォーマンスが40倍になり、同時に水の消費量を13分の1以上削減します。
NVIDIA GB200
NVL2について
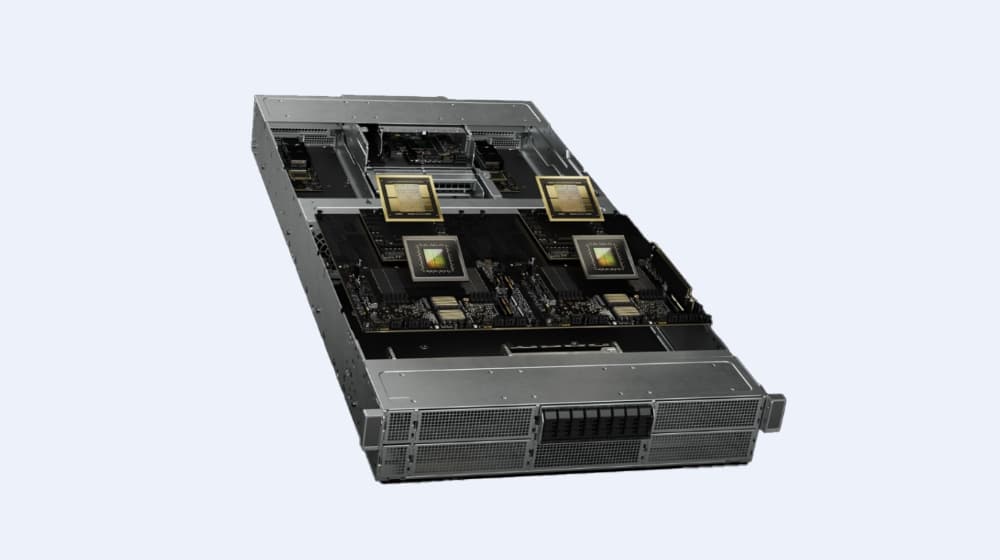
あらゆるデータセンターに新しい時代のコンピューティングをもたらし、2基の Blackwell GPU と2基のGrace CPU を通じて、主流の大規模言語モデル(LLM)推論、ベクトルデータベース検索、データ処理に比類のないパフォーマンスを提供します。
NVIDIA GB200 NVL2 の特長
-
リアルタイム メイン
ストリームLLM推論Grace CPU とBlackwell GPU が2基ずつで共有される最大1.3TBの大容量コヒーレントメモリの導入。この共有メモリが第5世代NVIDIA®NVLink™ と高速のチップ間(C2C)接続と連動し、Llama 3 70B などの主要な言語モデルで5倍の高速リアルタイム LLM推論パフォーマンスが提供可能に。
-
ベクトルデータベース
検索RAG ベクトル検索操作を最大9倍高速化。Wikipedia データセットのベクトルデータベースは200GBを超えます。Grace CPU の 960GB メモリと毎秒 900GB の高速 C2C リンクを利用することで、低遅延のベクトル検索が大幅に強化。
-
データ処理
高帯域幅のメモリパフォーマンス、NVLink-C2C、NVIDIA Blackwell アーキテクチャの専用の Decompression Engines を活用し、重要なデータベースクエリを CPU と比較して18倍高速化。
Compute/計算用途
-
NVIDIA H200
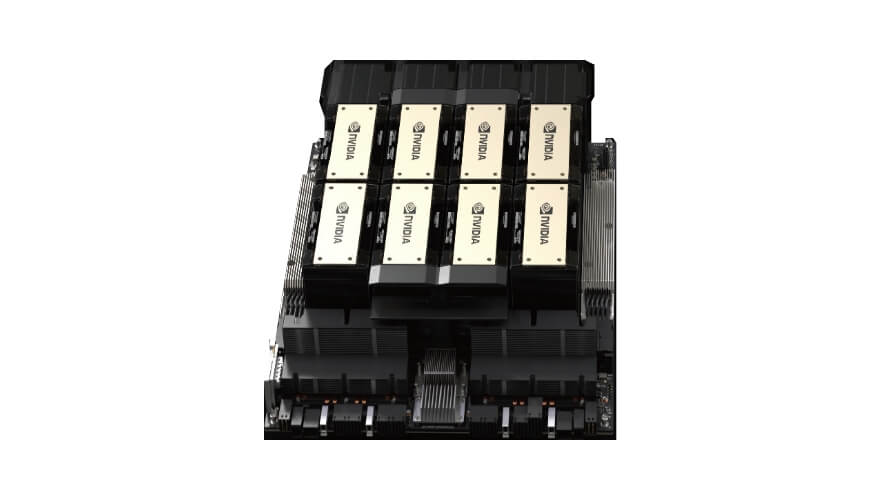
世界で最もパワフルな GPU
HBM3e を搭載した初の GPU である大容量かつ高速のメモリ
- 700W
- NVLINK
- 141GB
-
 大規模言語モデル (LLM)
-
 生成AI
-
NVIDIA H200 NVL
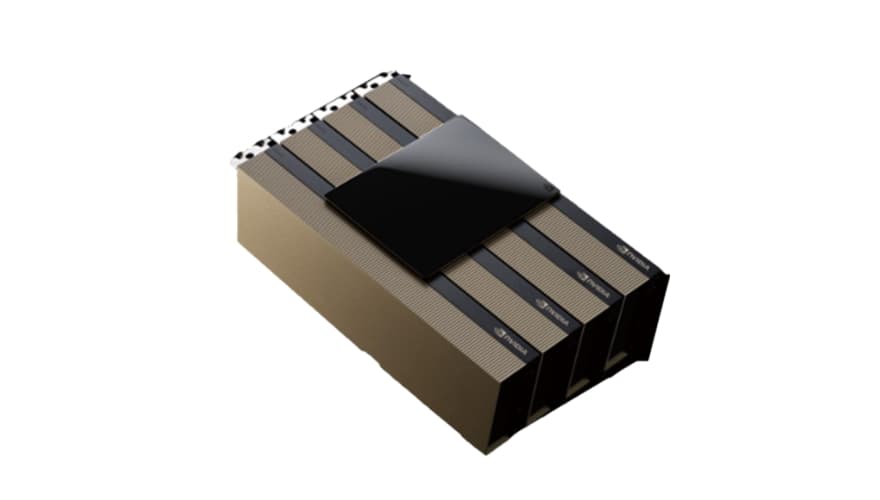
空冷式エンタープライズラック向け
低消費電力モデル GPUあらゆる規模のAIおよびHPC処理に対応
- 600W
- NVLINK
- 141GB
-
大規模言語モデル (LLM)
-
生成AI
-
販売終了
NVIDIA H100
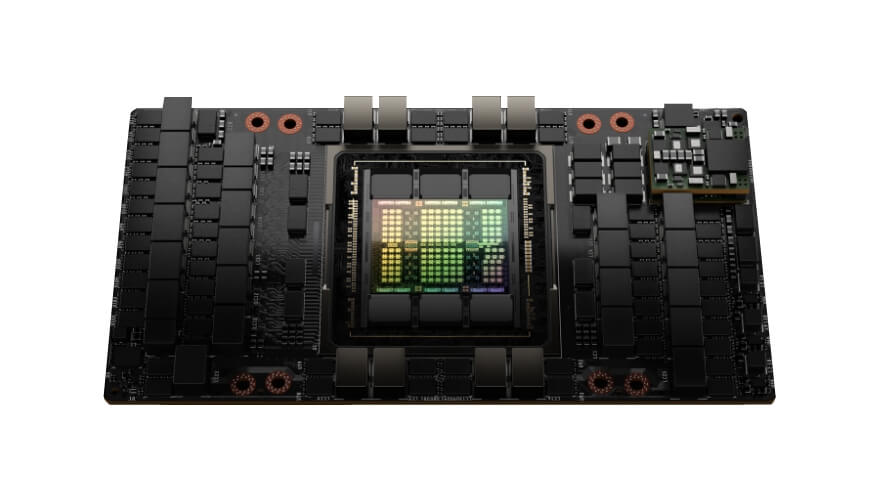
世界の AI インフラを支える
新しいエンジン変革的AIトレーニング、最大7つのMIGインスタンス
- 350w/700w
- NVLINK
- 80GB
-
DLトレーニング
-
 科学的な研究
-
 データ分析
-
販売終了
NVIDIA H100 NVL
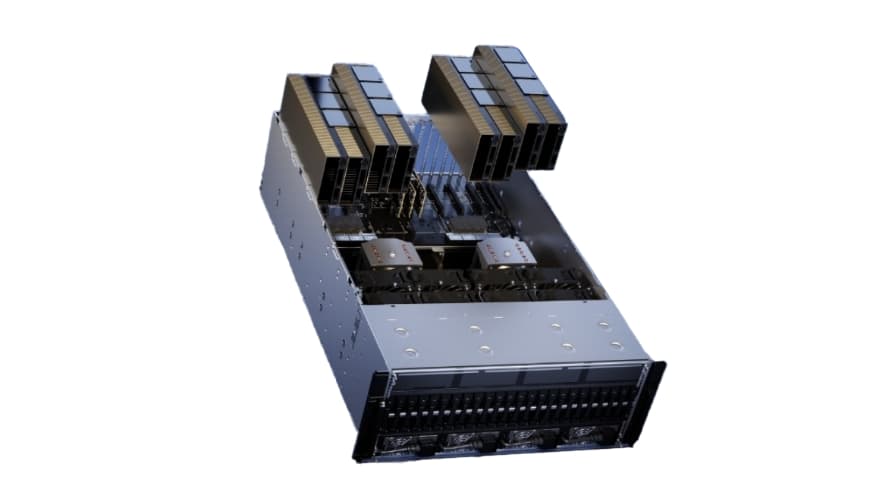
大規模言語モデル推論を加速
データセンターで最適な性能と容易な拡張性を提供
- 2×350‐400W
- NVLINK
- 2×94GB
記載の仕様はH100 NVL PCIe カード2枚と NVLink Bridge を組み合わせた場合の参考仕様です。
-
大規模言語モデル (LLM)
-
生成AI
Graphics and Compute/
グラフィックス用途および
計算用途
-
NVIDIA RTX PRO 6000
Blackwell Server Edition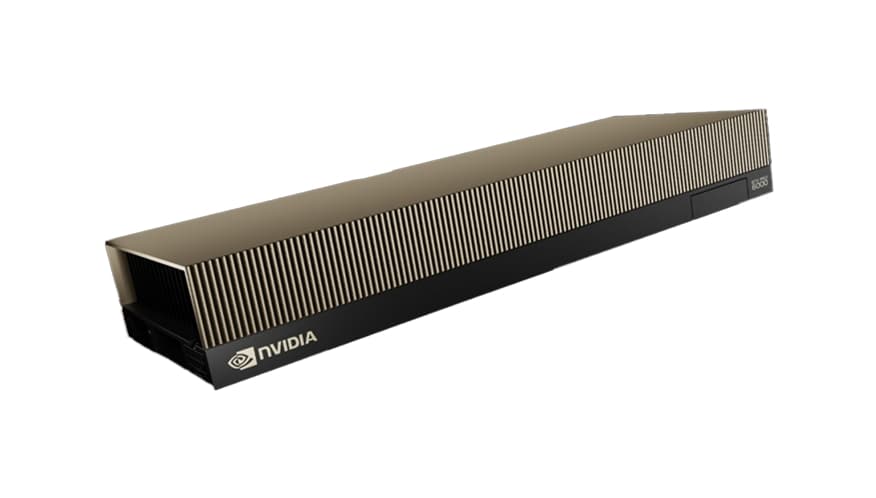
データセンター向け AIの処理能力と
高いビジュアルコンピューティング性能24時間365日稼働のエンタープライズデータセンターの
ワークロードに最適化- 600w
- 2-slot、FHFL
- 96GB GDDR7 (ECC搭載)
-
 エージェント型AI
-
 フィジカルAI
-
 科学計算
-
 レンダリング
-
 3Dグラフィックス
-
NVIDIA L40S
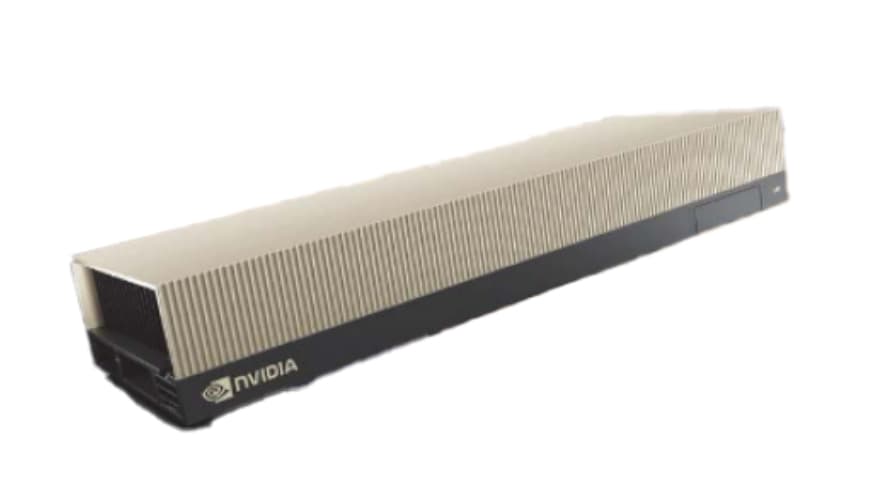
データセンターのAIとグラフィックで
発揮される高性能生成AIやLLMの推論、トレーニングから3Dグラフィックまで、
パワフルな汎用GPU- 350W
- 2-slot FHFL
- 48GB GDDR6 ECC付
-
大規模言語モデル(LLM)
-
生成AI
-
 クラウド上のレンダリング
-
 オムニバス
-
NVIDIA L4
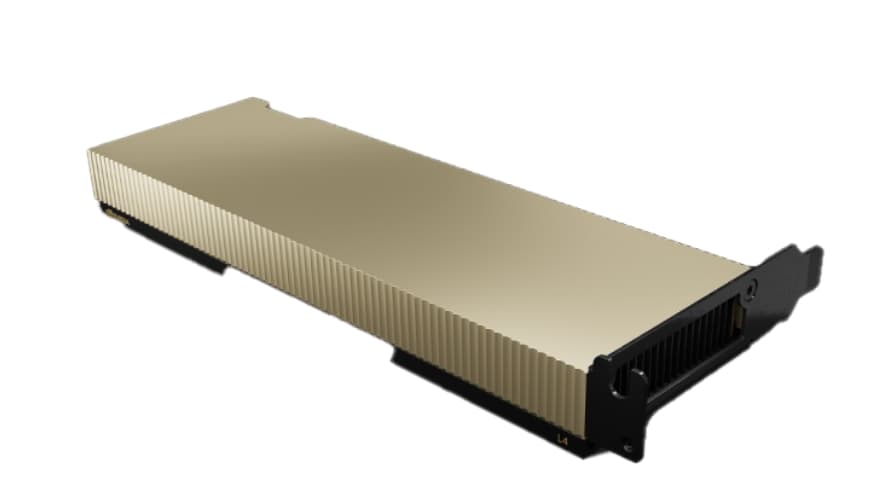
ビデオ、AI、グラフィックスの
ワークロードを加速高いスループットと低遅延を実現する費用対効果、
エネルギー効率に優れたGPU- 72W
- 1-slot FHFL
- 24GB GDDR6 ECC付
-
生成AI
-
 仮想ワークステーション
-
 ビジュアルコンピューティング
Graphics/
グラフィックス用途
-
NVIDIA A16
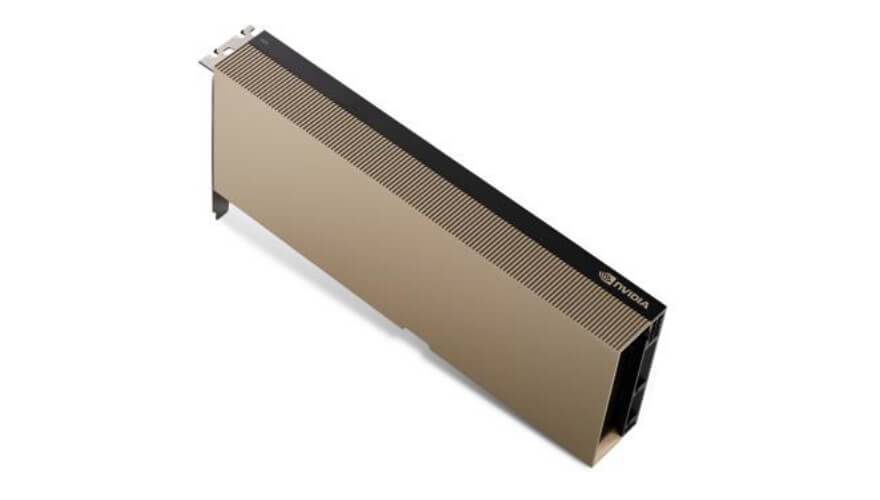
仮想デスクトップ用高密度搭載
可能モデル高解像度、マルチモニター、大容量のエンコード/
デコードストリーム- 250w
- 2-slot FHFL
- 4×16GB
-
 仮想デスクトップ
-
 トランスコーディング
-
販売終了
NVIDIA A40
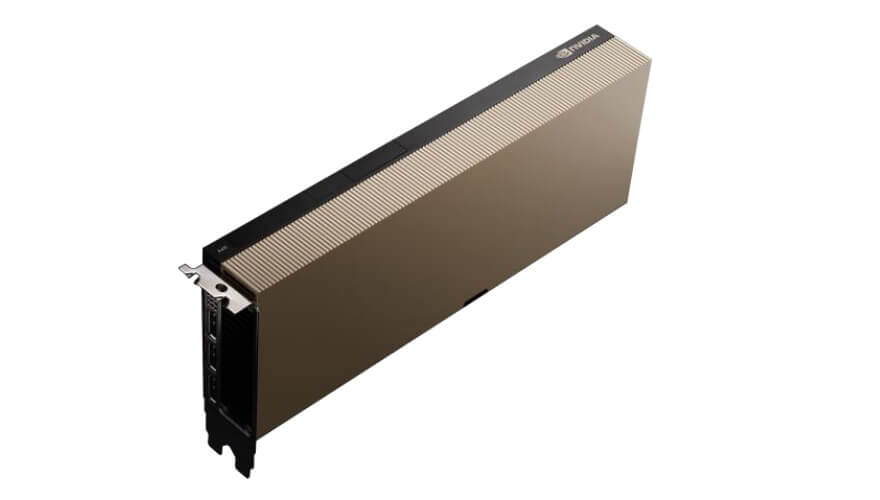
グラフィックスのハイエンド
レンダリング、
デザイン、OmniverseCloudXR最高速のRTグラフィックス 最高のレンダリングモデル
- 300w
- 2-slot FHFL
- 48GB
- NVLINK
-
クラウド上のレンダリング
-
 クラウド上のXR
-
オムニバス
-
販売終了
NVIDIA A10
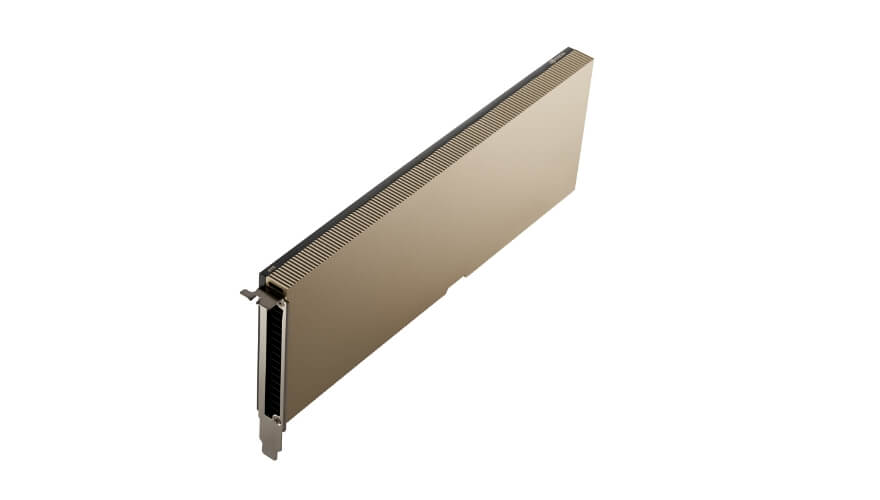
グラフィックスのスタンダードAIを
使用したビデオ4Kクラウドゲームグラフィック、AIを使用したビデオ
- 150w
- 1-slot FHFL
- 24GB
-
仮想ワークステーション
-
 ビデオミーティング
-
 4Kクラウドゲーム
データセンター向け
GPU比較表
| NVIDIA H200 | NVIDIA H200 NVL | NVIDIA RTX PRO 6000 Blackwell | NVIDIA L40S | NVIDIA L4 | NVIDIA A16 | |
|---|---|---|---|---|---|---|
| Design | Highest Perf AI, HPC & Data Processing | Highest Perf AI, Graphics & Visual Computing | Mainstream Graphics, Video & AI | High-Density Virtual Desktop & Video | ||
| GPU Memory | 141GB HBM3e | 96GB GDDR7 ECC付 | 48GB GDDR6 ECC付 | 24GB GDDR6 ECC付 | 4×16GB (64GB) GDDR6 | |
| Multi-Instance GPU | Up to 7 MIGs | Up to 4 MIGs | N/A | N/A (4 GPUs per board) |
||
| Ray Tracing | No | Yes | ||||
| FT8 | Yes | No | ||||
| Fast FP64 | Yes | No | ||||
| Graphics | N/A | Best | Better | Good | ||
| Max Power | 700W / 350W | 600W | 350W | 72W | 250W | |